Entre la tarde del jueves 12 y la mañana del sábado 14 de Noviembre de 2026, millones de personas en todo el mundo no pudieron usar con normalidad el correo de trabajo de Outlook, Teams, Copilot y otras herramientas de Microsoft 365. El problema duró más de 24 horas, se reportó en más de 70 países y alcanzó a hospitales, tribunales, gobiernos, bancos y aerolíneas, según Reuters, AP y la BBC.
Publicado el 14 de Noviembre de 2026.
Microsoft asegura que no fue un ciberataque ni un fallo provocado por inteligencia artificial, sino un problema técnico que se introdujo durante una ampliación anterior de su red. La empresa ha pedido disculpas y ha prometido un informe completo, que a fecha de hoy todavía no ha publicado.
Aquí te explicamos, paso a paso y en lenguaje claro, qué pasó.
En resumen
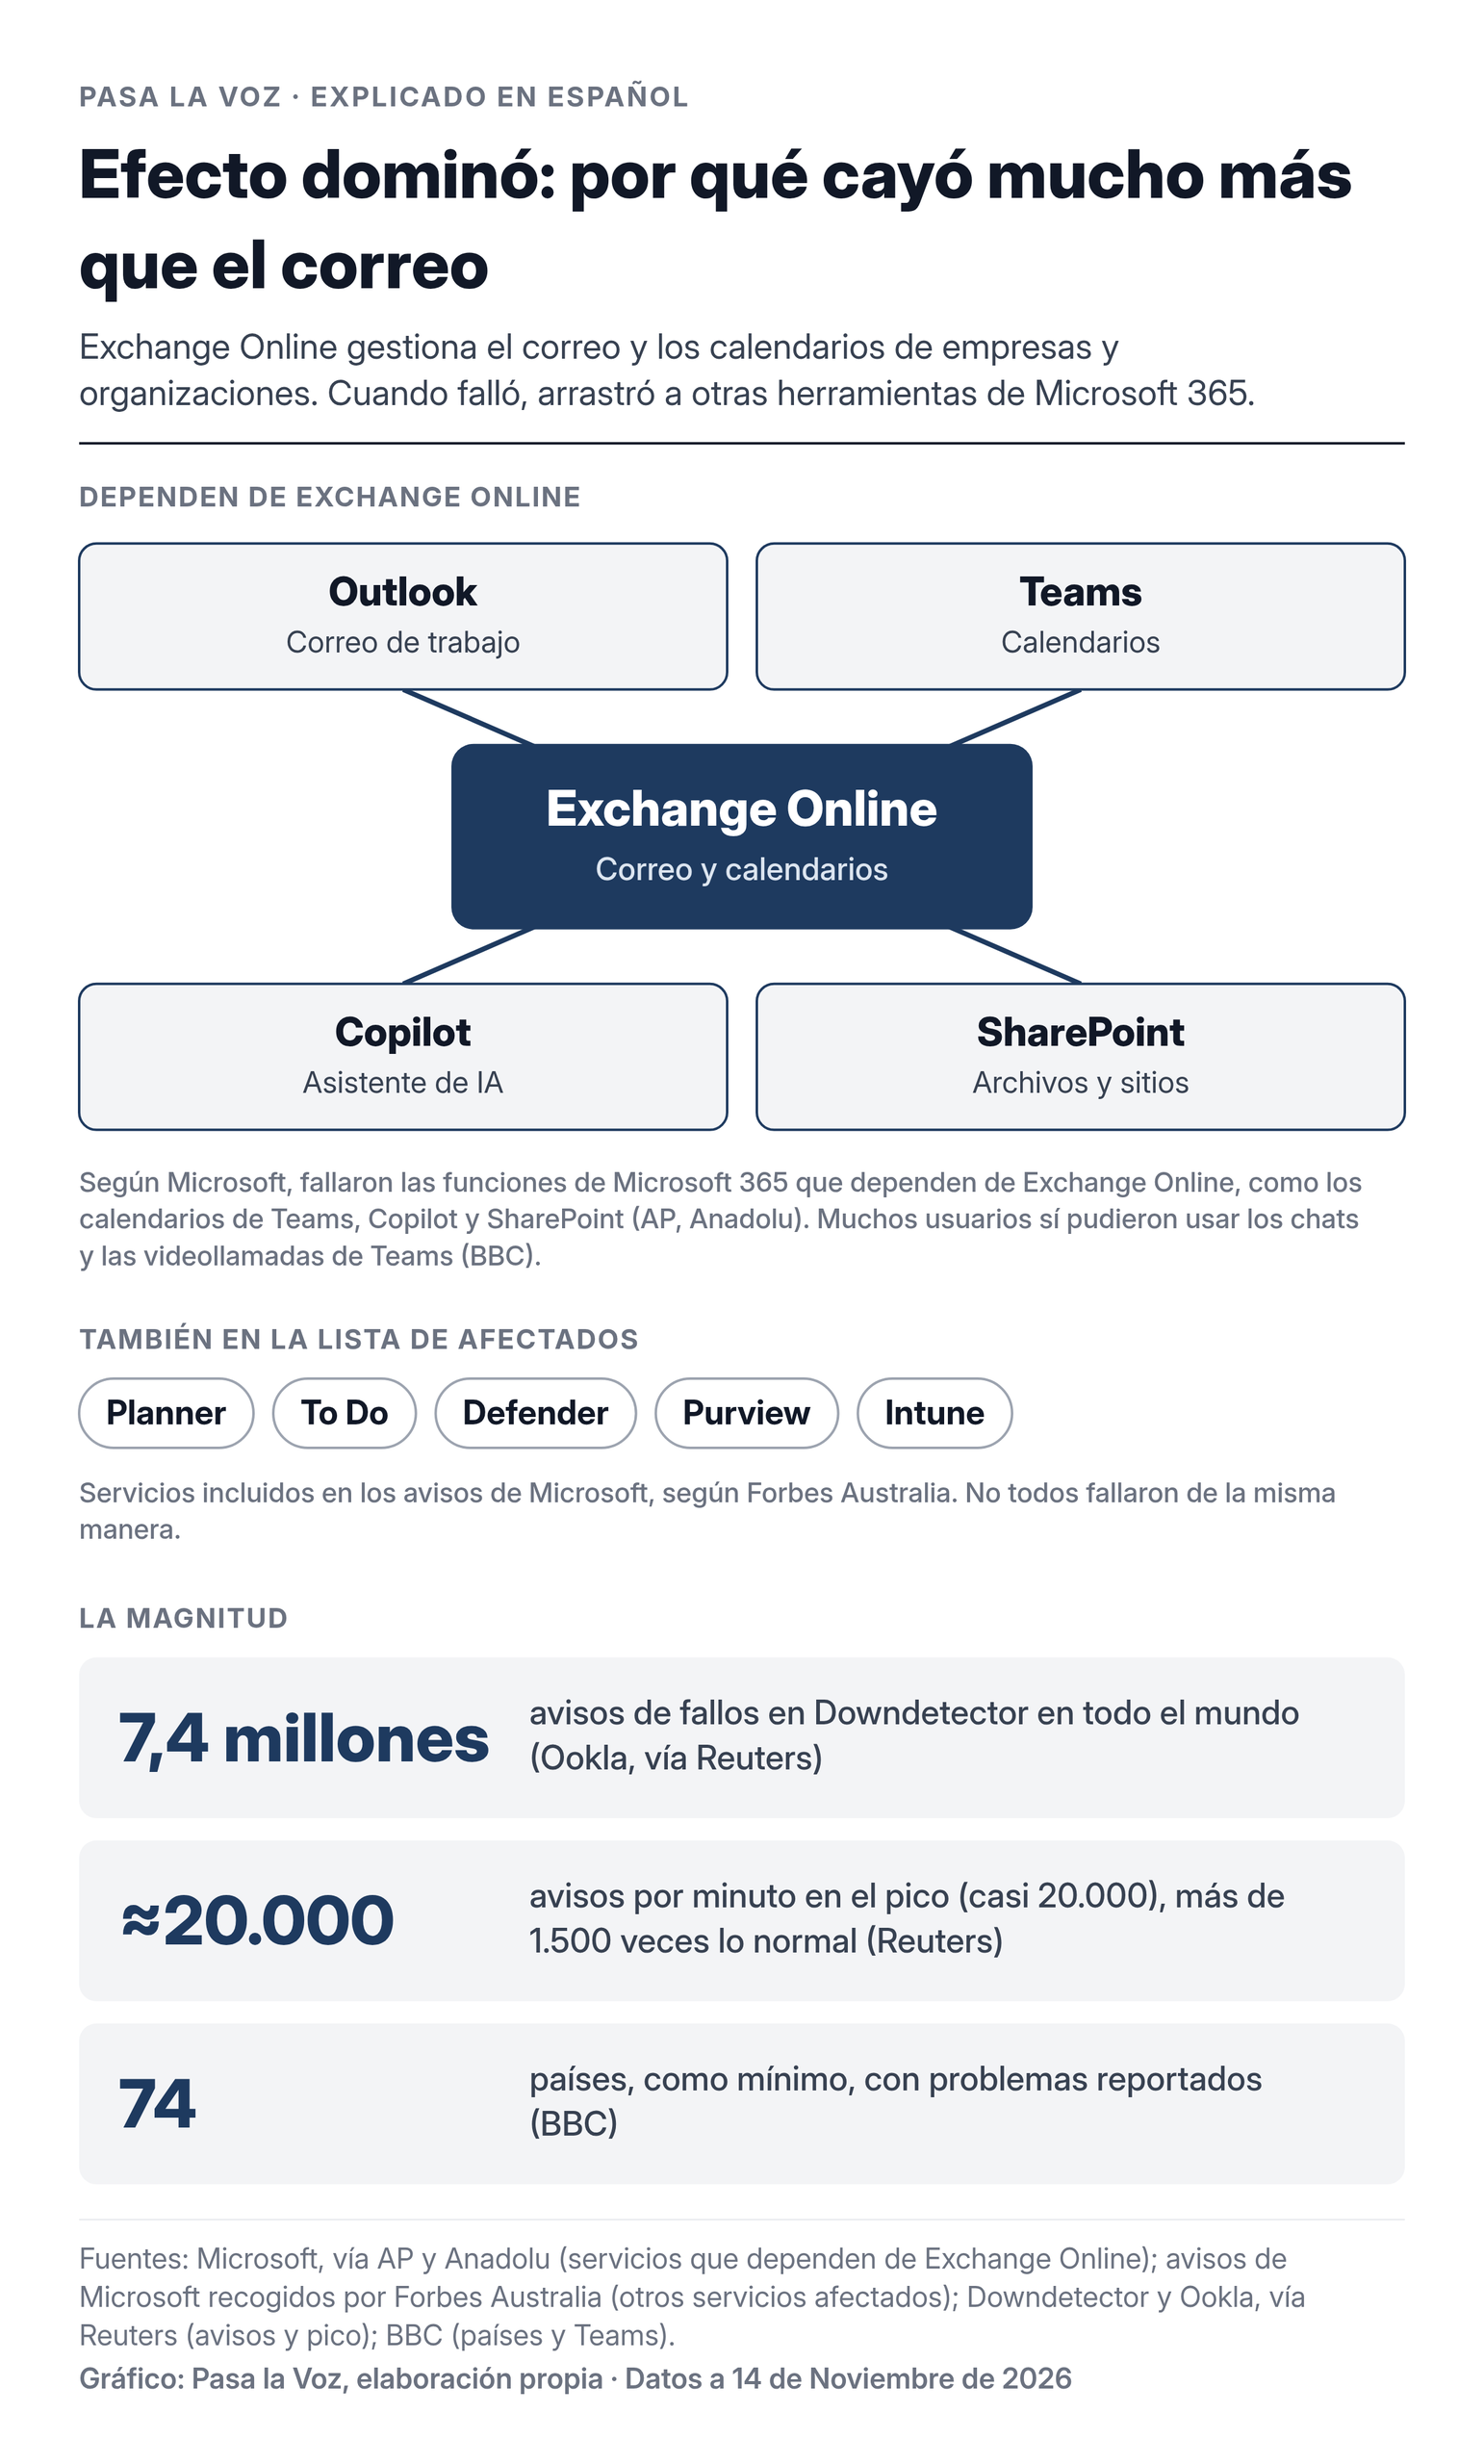
- Qué falló: Exchange Online, el sistema de Microsoft que gestiona el correo y los calendarios de empresas y organizaciones. Al caer, arrastró a otras herramientas que dependen de él, como los calendarios de Teams, Copilot o SharePoint.
- Cuánto duró: más de 24 horas de interrupción grave. Microsoft dio el primer aviso el jueves 12 a las 17:54 (UTC) y no anunció que había restablecido el servicio a todos los clientes hasta el sábado 14 a las 06:09 (UTC).
- Por qué, según Microsoft: un problema introducido durante una ampliación anterior de la capacidad de su red, que salió a la luz tras un cambio reciente en esa red.
- Qué no fue: Microsoft dice que no hay indicios de ciberataque ni de actividad maliciosa, y que tampoco tuvo que ver con la inteligencia artificial.
- Qué falta: el informe técnico completo de Microsoft, que la empresa ha prometido pero no ha publicado todavía.
Primero, dos conceptos
La nube. Microsoft 365 es el paquete de herramientas de oficina de Microsoft (Outlook, Teams, Word, Excel, SharePoint, Copilot…). Funciona «en la nube»: tus correos, archivos y calendarios no están solo en tu ordenador o en tu móvil, sino en enormes centros de datos de Microsoft a los que te conectas por internet. Si esos servidores fallan, da igual que tu ordenador funcione perfectamente: no puedes llegar a tus datos.
Exchange Online. Es la pieza de Microsoft 365 que mueve el correo y los calendarios de las organizaciones que usan Outlook. Muchas otras funciones se apoyan en ella, y por eso, cuando falló, también dejaron de funcionar bien los calendarios de Teams, Copilot o SharePoint, según explicó Microsoft. Las aplicaciones que no dependen de Exchange Online siguieron funcionando, recoge Reuters.
Qué pasó, paso a paso
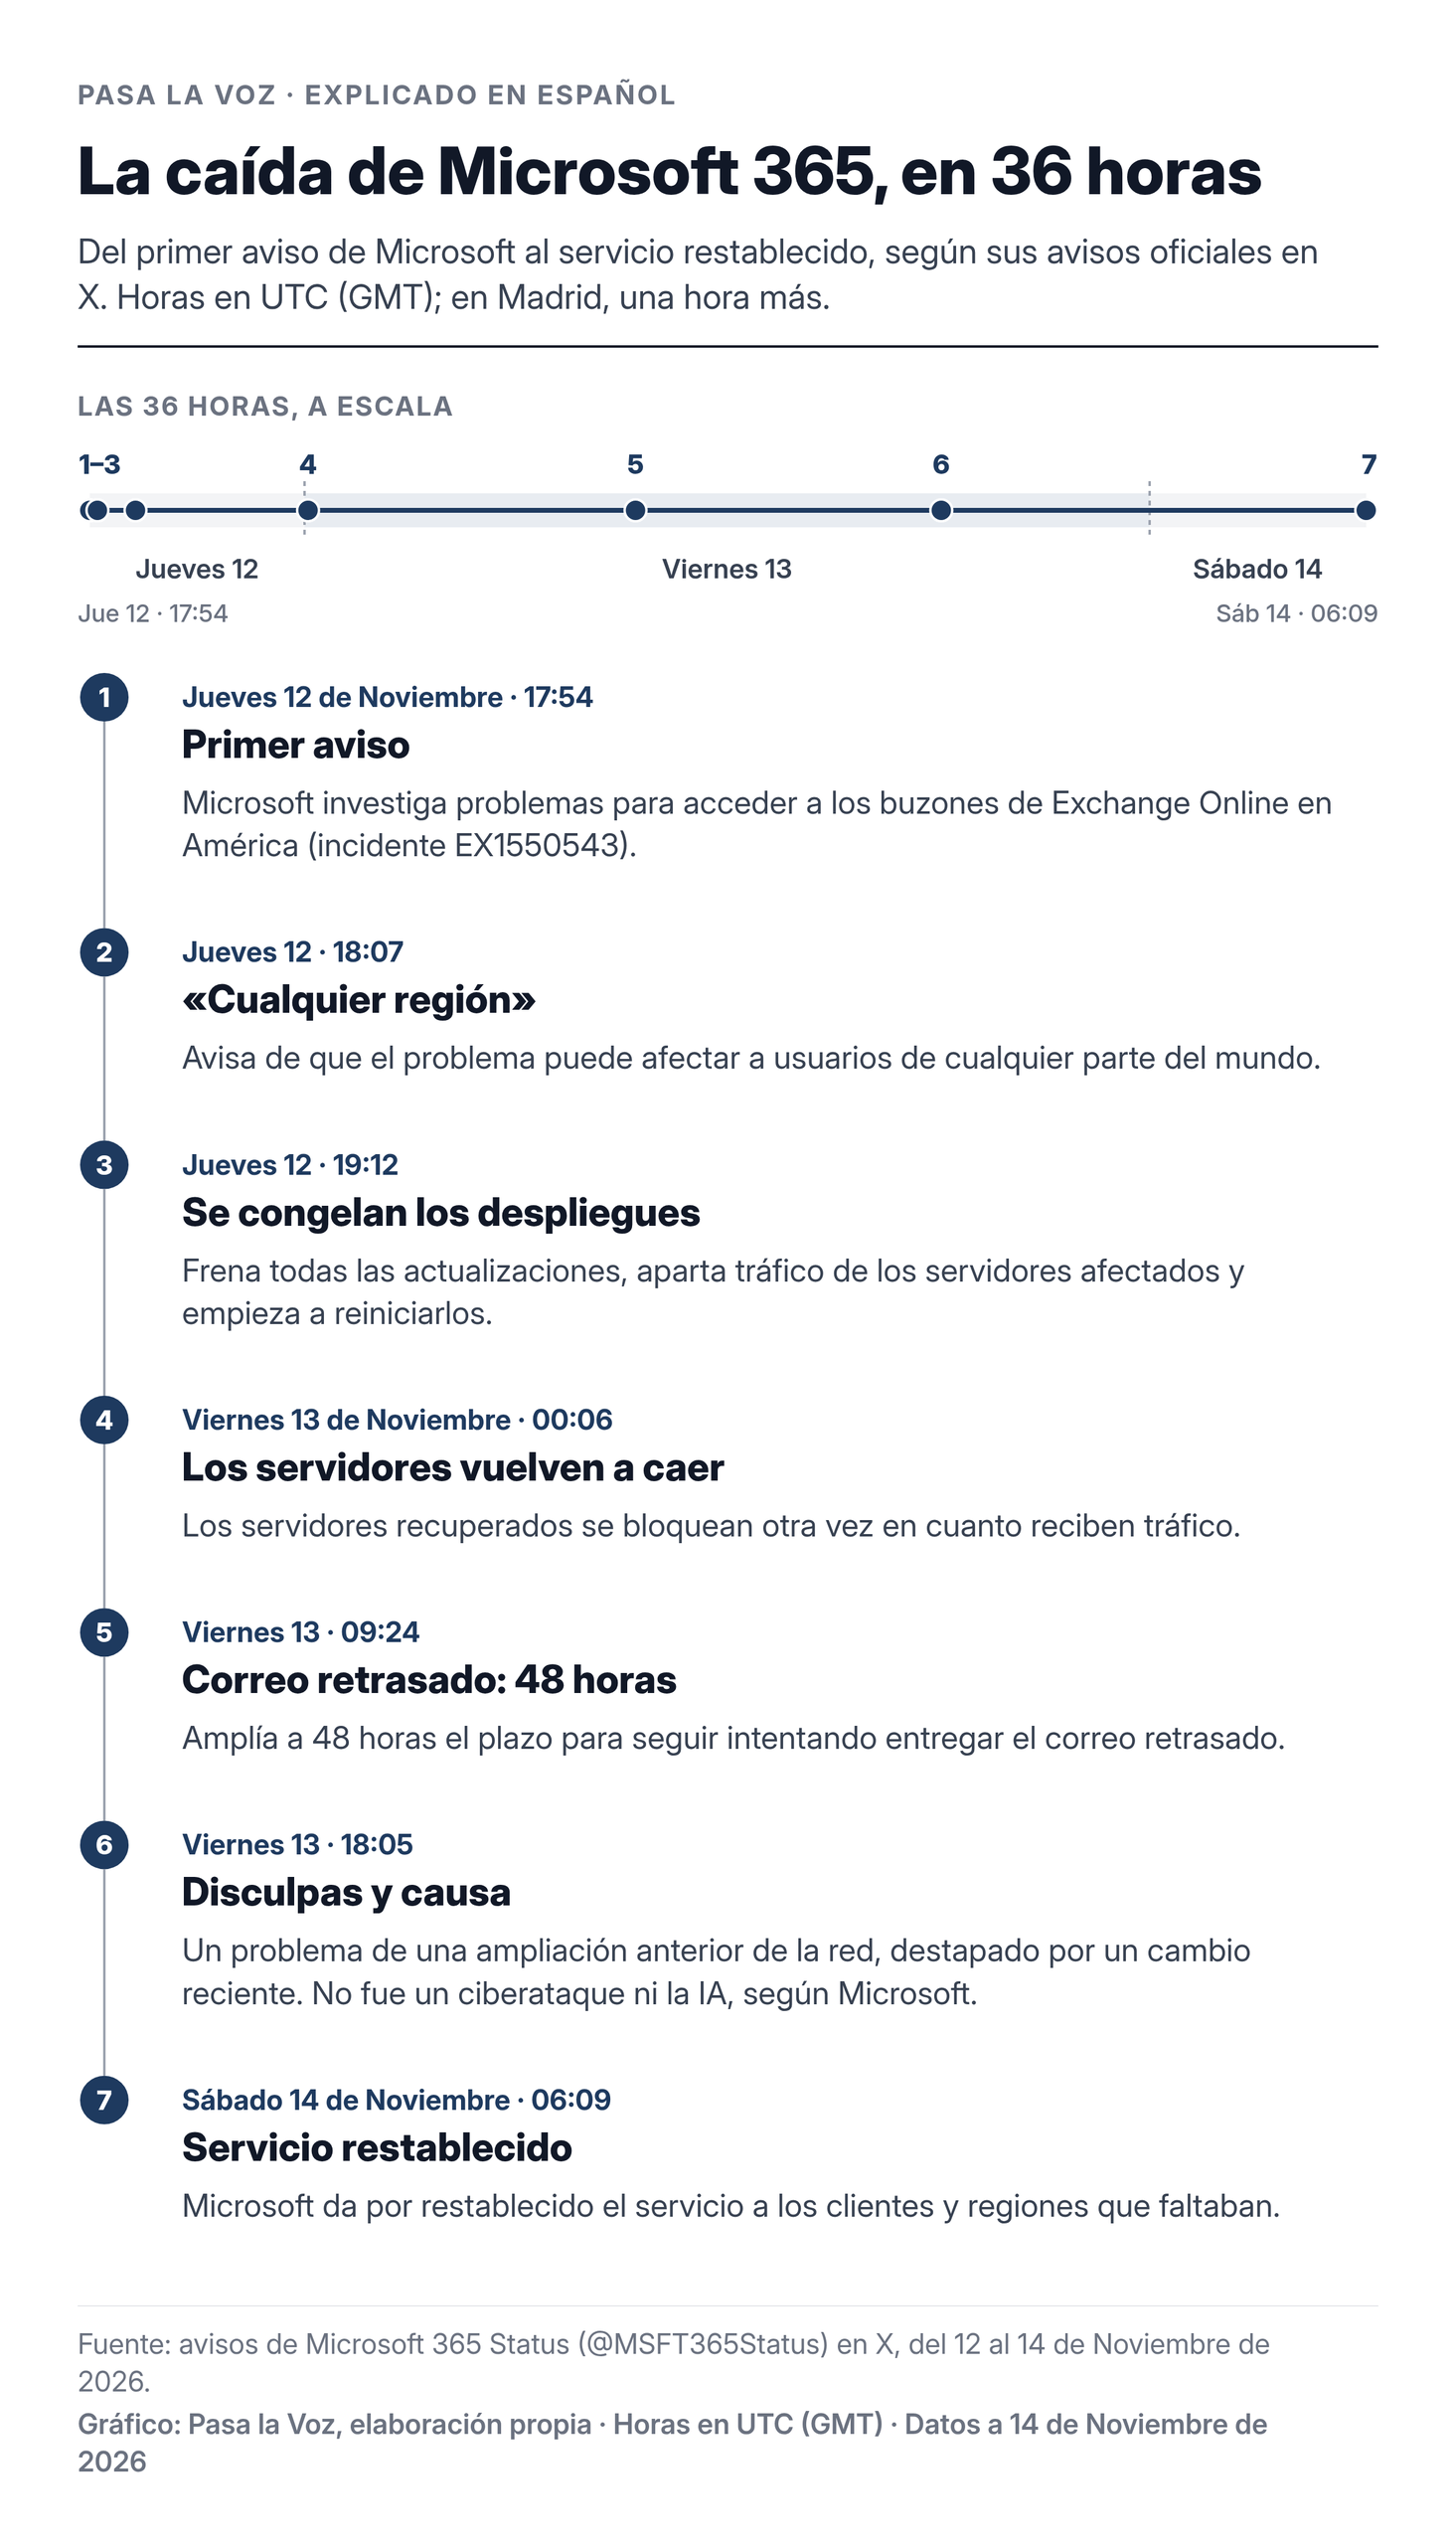
Esta cronología se basa sobre todo en los avisos que publicó la cuenta oficial Microsoft 365 Status (@MSFT365Status) en X. Horas en UTC.
Jueves, 12 de Noviembre de 2026
- Hacia las 17:25 — Empiezan a dispararse los avisos de fallos en Downdetector, la web donde los usuarios informan de problemas, según su empresa matriz, Ookla (Reuters).
- 17:54 — Microsoft confirma que investiga problemas para acceder a los buzones de Exchange Online en América. Abre el incidente EX1550543.
- 18:07 — Amplía el aviso: el problema puede afectar a usuarios de cualquier región del mundo.
- 18:35 y 18:48 — Detecta una «carga elevada» en parte de su infraestructura en varias regiones y empieza a repartir el tráfico por el resto de su red mundial.
- 19:12 — Congela todos los despliegues (es decir, frena cualquier actualización en marcha), desvía tráfico fuera de los equipos afectados y empieza a reiniciar servidores.
- 19:31 — Aclara que no hay más tráfico de lo normal: el problema es que varios servidores han dejado de estar disponibles de forma inesperada y los que quedan están sobrecargados.
- 19:50 y 20:19 — Explica que los servidores están suspendiendo las «comprobaciones de salud» automáticas (las pruebas con las que el sistema decide si un servidor está en condiciones de trabajar) y que el fallo podría venir del componente que procesa esas comprobaciones. En ese momento dice que no ha encontrado ningún cambio reciente que coincida con el inicio del problema.
- 21:00 — Un método alternativo de comprobación permite devolver al servicio una parte de los servidores.
- 21:40 — Estudia deshacer algunos cambios de configuración recientes por si eso acelera la recuperación.
- 22:09 — Reconoce que lo intentado hasta entonces «no ha dado el alivio esperado» y que un proceso central de los servidores afectados se está saturando.
- 23:04 — Una parte de los servidores vuelve a funcionar y se mantiene estable.
Viernes, 13 de Noviembre de 2026
- 00:06 — Contratiempo: los servidores recuperados vuelven a quedarse bloqueados en cuanto reciben tráfico. Microsoft limita qué tipos de tráfico pueden llegarles y reconstruye algunos con una configuración anterior para ver si así aguantan.
- 01:59 — Reiniciar los equipos por partes, de forma aislada, empieza a dar «resultados positivos».
- 03:13 — Admite que los cambios aplicados «no están funcionando como se esperaba» y busca otras vías para ganar capacidad.
- 04:36 — Ajusta, redistribuye y bloquea parte del tráfico. Hay recuperación parcial en algunas regiones, pero todavía no se sostiene.
- 07:44 — Las últimas medidas sobre el tráfico dan «resultados positivos» de estabilidad y capacidad, y empiezan a aplicarse en más regiones.
- 09:24 — Para que no se pierdan los correos retrasados, Microsoft amplía a 48 horas el tiempo durante el que el sistema sigue intentando entregarlos.
- 13:32 — Mejora general en Norteamérica, mejora sostenida en gran parte de Europa y «señales alentadoras» en Asia-Pacífico.
- 14:17 — Las colas de correo pendiente están «cerca de niveles normales», aunque algunos usuarios siguen teniendo fallos intermitentes.
- 15:39 — Microsoft afirma que no hay indicios de actividad maliciosa o ciberataque.
- 18:05 — Pide disculpas públicamente y da su explicación de la causa (ver más abajo).
- 20:05 — Todavía sin fecha para la recuperación total: advierte de que el acceso puede volver antes de que el correo circule con normalidad.
- 21:55 — Dice que mantendrá la vigilancia durante un periodo prolongado y que revisará que se procese todo el correo acumulado antes de dar el problema por resuelto.
Sábado, 14 de Noviembre de 2026
- 06:09 — Microsoft anuncia que ha terminado de resolver la causa del incidente y que ha restablecido el servicio a los clientes y regiones que todavía estaban afectados.
Por qué ocurrió
La explicación oficial de Microsoft, publicada el viernes 13, es esta: «Fue un problema técnico no relacionado con ciberataques ni con la IA o los agentes. El incidente se introdujo por un problema durante una ampliación anterior de la capacidad de la red, que salió a la luz tras un cambio reciente en la red».
Dicho de forma sencilla: en algún momento anterior, Microsoft amplió su red para que pudiera soportar más tráfico. En esa ampliación quedó un fallo escondido que no dio la cara hasta que, más tarde, se hizo otro cambio en la red. Microsoft no ha explicado todavía qué fallo era exactamente ni qué cambio lo destapó.
Lo que sí contó durante la crisis ayuda a entender el efecto dominó. Muchos servidores empezaron a suspender las comprobaciones automáticas que deciden si un servidor está sano, y el sistema los fue apartando del servicio. Todo el trabajo recayó entonces en los que quedaban, que acabaron sobrecargados. Microsoft subrayó que no había más usuarios de lo normal: había menos servidores para atenderlos.
Es como un supermercado en hora punta en el que, de repente, se cierran la mitad de las cajas: las colas se pasan a las cajas abiertas, que se colapsan. Y cuando se intenta reabrir una caja, se le echa encima toda la gente que espera y vuelve a bloquearse. Eso es, en esencia, lo que Microsoft describió la madrugada del viernes: los servidores que recuperaba volvían a quedarse sin respuesta en cuanto recibían tráfico.
El profesor James Ferryman, del departamento de informática de la Universidad de Reading, lo resumió así en la BBC, a partir de los datos que había dado Microsoft: la parte de los servidores que establece las conexiones seguras se satura y el servidor deja de responder; su trabajo pasa al siguiente, mientras muchísimos móviles y ordenadores siguen intentando reconectarse. «No puedes encenderlo todo a la vez. Tienes que devolverlo poco a poco», explicó.
Por eso tardó tanto. La propia Microsoft lo reconoció: «Dada la magnitud de la demanda, restablecimos los servicios de forma gradual, validando la estabilidad en cada fase. Aunque llevó más tiempo, ayudó a garantizar una recuperación estable».
Un detalle importante: el jueves por la noche Microsoft dijo que no había encontrado ningún cambio reciente que coincidiera con el inicio del problema; al día siguiente atribuyó la causa a la ampliación de red y a un cambio posterior. La empresa no ha detallado cómo encajan ambas cosas. Habrá que esperar a su informe completo.
A quién afectó
Sobre todo, a empresas, administraciones y organizaciones que usan Microsoft 365 para su correo de trabajo. Muchos usuarios no podían enviar ni recibir correos, abrir algunos archivos o ver sus calendarios; otros, en cambio, podían seguir usando los chats y las videollamadas de Teams sin problemas, según la BBC. Las organizaciones que tienen los servicios de Microsoft instalados en sus propios servidores, y no en la nube, se libraron en parte (Reuters).
La magnitud
- Downdetector registró más de 7,4 millones de avisos de fallos en todo el mundo, con un pico de casi 20.000 por minuto, más de 1.500 veces lo habitual (Ookla, citada por Reuters).
- Hubo avisos de usuarios en al menos 74 países, según la BBC, y en más de 70 países y territorios, según AP.
- Microsoft dice en su web que más de 430 millones de personas usan las aplicaciones de Microsoft 365, pero el número real de afectados no se ha confirmado (BBC).
- Los picos de avisos coincidieron con el inicio de la jornada laboral en Asia y Europa (Ookla, citada por Reuters).
Servicios afectados
Además del correo de Outlook, la lista de servicios afectados que recogió Forbes Australia a partir de los avisos de Microsoft incluye Teams, SharePoint, Microsoft 365 Copilot, Planner, To Do, las herramientas de seguridad Defender, Purview (protección de datos), Intune (gestión de portátiles y móviles de empresa), algunas funciones de Power BI y el servicio de impresión Universal Print. No todos fallaron de la misma manera: en muchos casos fallaban solo las funciones que dependen del correo.
Algunos ejemplos reales
- Sanidad. En Reino Unido, el NHS (la sanidad pública) se vio muy afectado: parte del personal tuvo que recurrir a registros en papel (DW, Reuters). Algunos centros de salud pidieron a los pacientes no enviar mensajes por su web (BBC). En Canadá, una red de hospitales de Toronto tuvo problemas con el correo, aunque la atención a pacientes no se vio afectada (CBC, citada por la BBC).
- Policía y justicia. La Policía Metropolitana de Londres no podía recibir algunas denuncias por internet, aunque seguía atendiendo llamadas (Reuters). Tribunales desde Los Ángeles hasta Texas avisaron de retrasos en sus comunicaciones (BBC).
- Gobiernos. El Gobierno de Japón informó de fallos en su plataforma informática compartida (BBC). En Australia se vieron afectados, entre otros, la agencia de inteligencia y la policía federal (Reuters). En Alemania, el Ministerio de Transformación Digital dijo que el impacto en el Gobierno federal no fue grave, pero sí en las empresas alemanas (DW).
- Empresas y finanzas. El operador bursátil Euronext sufrió problemas de correo; la aseguradora británica Aviva activó sistemas de respaldo para sus presentaciones de resultados, y la naviera Maersk avisó a sus clientes de retrasos en sus comunicaciones (Reuters). En Taiwán, una empresa financiera llegó a confirmar operaciones por fax, según una fuente citada por Reuters. Richemont retrasó brevemente la publicación de sus resultados y Workhorse los aplazó al 16 de Noviembre (CNBC, Reuters).
- Aerolíneas. IndiGo, Akasa Air y Air India informaron de problemas en su atención por correo (Reuters). Air India desvió temporalmente sus correos y aclaró que sus vuelos no se vieron afectados (CNBC).
- Otras tecnológicas. OpenAI (la empresa de ChatGPT) y Anthropic tuvieron problemas en sus conexiones con servicios de Microsoft, que después se resolvieron (Reuters, BBC).
Otros datos para entenderlo
El jueves también hubo usuarios que informaron de fallos en servicios de Amazon (AWS) y Google. Amazon respondió que sus servicios funcionaban con normalidad y que «una interrupción ajena en otro punto de internet» estaba provocando informaciones inexactas (CNBC). Según DW, tampoco se cree que la caída de Microsoft esté relacionada con el grave fallo de comunicaciones que afectó a la aviación en Estados Unidos.
En bolsa, las acciones de Microsoft cerraron el viernes prácticamente planas, a 523,88 dólares (Reuters). La agencia de calificación Morningstar DBRS estimó las pérdidas aseguradas en todo el mundo entre 300 y 500 millones de dólares; es una estimación, no una cifra oficial (Reuters).
No es la primera vez este año: Reuters recuerda que Microsoft 365 ya sufrió una caída en enero y que el mes pasado hubo otra en Azure, la nube de Microsoft para empresas.
Qué ha dicho Microsoft
- Disculpas. «Lamentamos profundamente las molestias que este incidente ha causado a nuestros clientes y socios. Sabemos la confianza que depositan en nuestros servicios y nos tomamos esa responsabilidad muy en serio».
- No fue un ataque. Microsoft afirma que no hay indicios de actividad maliciosa ni de ciberataque, y que el problema no tuvo relación con la inteligencia artificial.
- Causa. Un problema introducido durante una ampliación anterior de la capacidad de su red, que salió a la luz tras un cambio reciente en la red. Dice que ya lo ha corregido.
- Informe pendiente. Ha prometido publicar «un informe completo posterior al incidente» cuando termine su revisión, y dice que sus equipos estudian cómo evitar que algo así se repita.
- Fin del incidente. El sábado 14 de Noviembre de 2026 a las 06:09 (UTC) anunció que había restablecido el servicio para los clientes y regiones que seguían afectados.
- ¿Habrá compensación? Microsoft no ha anunciado ninguna compensación específica por esta caída. Sus contratos de servicio para empresas permiten pedir descuentos en futuras facturas (los llamados créditos de servicio) cuando un servicio cae por debajo de la disponibilidad garantizada, pero no son automáticos ni se pagan en dinero: hay que solicitarlos (Microsoft Learn, The Economic Times). No está claro que los usuarios particulares puedan recibir nada.
Qué puedes hacer tú y qué aprender
- Si enviaste o esperabas un correo importante esos días, confirma que llegó. Microsoft amplió a 48 horas el margen para entregar el correo retrasado, así que muchos mensajes llegaron tarde. Ojo: aparecen con la hora en que se entregaron, no con la hora en que se enviaron (BBC).
- Si tienes una empresa que paga Microsoft 365, guarda constancia de cuánto tiempo y a cuántas personas afectó. Para pedir créditos de servicio se suele solicitar desde el centro de administración de Microsoft 365 citando los números de incidente EX1550543 y MO1550821; si compraste las licencias a través de un distribuidor, es él quien lo tramita. Revisa en tu contrato el plazo que te aplica (Microsoft Learn, The Economic Times).
- Para saber si un fallo es tuyo o de Microsoft, la empresa publica el estado de sus servicios en status.cloud.microsoft y en la cuenta @MSFT365Status de X.
- La lección de fondo: cada vez más trabajo pasa por muy pocos proveedores. «Muestra cuánto de la jornada laboral pasa ya por las herramientas de correo y colaboración de un solo proveedor», resumió Luke Kehoe, analista de Ookla (Reuters). James Owen, de la consultora Control Risks, recomendó en CNBC tener un plan B: copias de seguridad manuales, sistemas que no dependan de internet, varios proveedores y ensayos de cómo actuar ante una crisis.
Lo que todavía no se sabe
- El informe completo de Microsoft: qué falló exactamente en la ampliación de red, qué cambio posterior lo destapó y por qué el jueves la empresa dijo no haber encontrado ningún cambio relacionado.
- Cuántas personas y organizaciones se vieron afectadas en total.
- La hora exacta de inicio: los avisos de usuarios empezaron a dispararse hacia las 17:25 (UTC), según Ookla, y el primer aviso público de Microsoft llegó a las 17:54.
- Si habrá algún tipo de compensación más allá de los créditos de servicio habituales para empresas.
Actualizaremos este artículo cuando Microsoft publique su informe.
Fuentes
- Microsoft 365 Status (cuenta oficial en X) — hilo de avisos — 12–14 Nov 2026: primer aviso · explicación de la causa y disculpas · fin del incidente
- Microsoft — estado de los servicios (status.cloud.microsoft)
- Reuters (vía Investing.com) — «Microsoft restores service to Outlook and Teams after global outage» — 14 Nov 2026
- AP — «Microsoft says services fully restored after hourslong global outage»
- BBC — «Why is Microsoft’s outage lasting so long and will emails be lost?» — 13 Nov 2026
- CNBC — «Microsoft apologizes for massive outage that took down Outlook and other 365 services» — 12 Nov 2026
- DW — «Microsoft says all services working again» — 14 Nov 2026
- Anadolu Agency — «Microsoft says global outage caused by technical issue, not cyberattack or AI» — 13 Nov 2026
- Forbes Australia — «Outlook and Teams recover from 24-hour outage as Microsoft says it’s ‘deeply sorry’» — 14 Nov 2026
- Microsoft Learn — «Request a credit from Microsoft» (créditos por caídas de servicio)
- The Economic Times — compensaciones a empresas por la caída